Analyse de données & apprentissage par renforcement
TP de Machine Learning (M2) : un petit jeu de plateau — un agent, des dragons, des diamants — où la machine apprend seule le chemin optimal, d'abord par Q-Learning tabulaire, puis par Deep Q-Learning.
À propos du projet
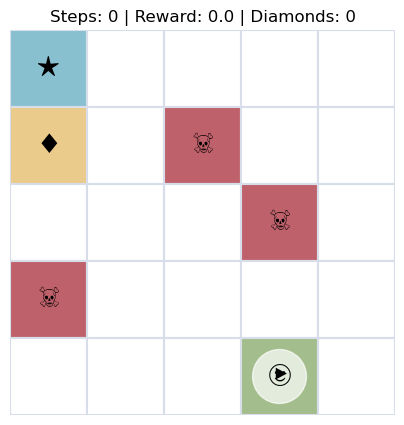
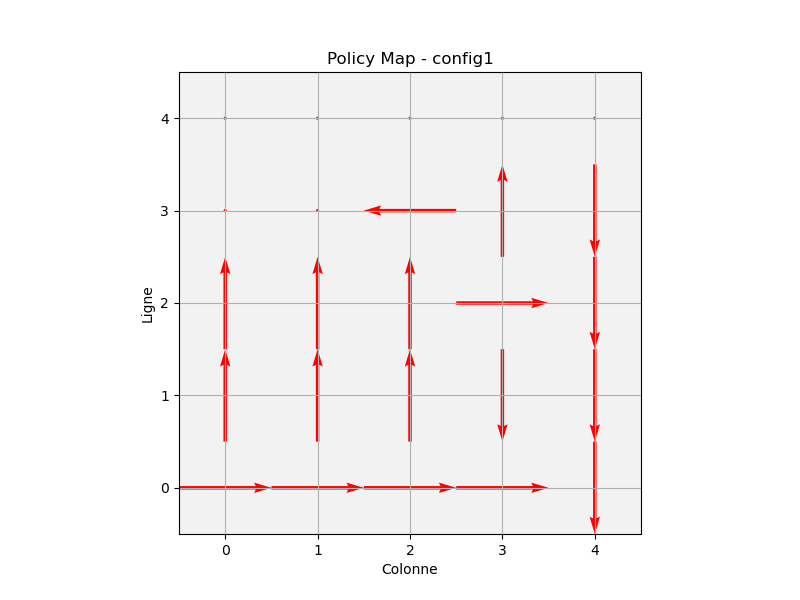
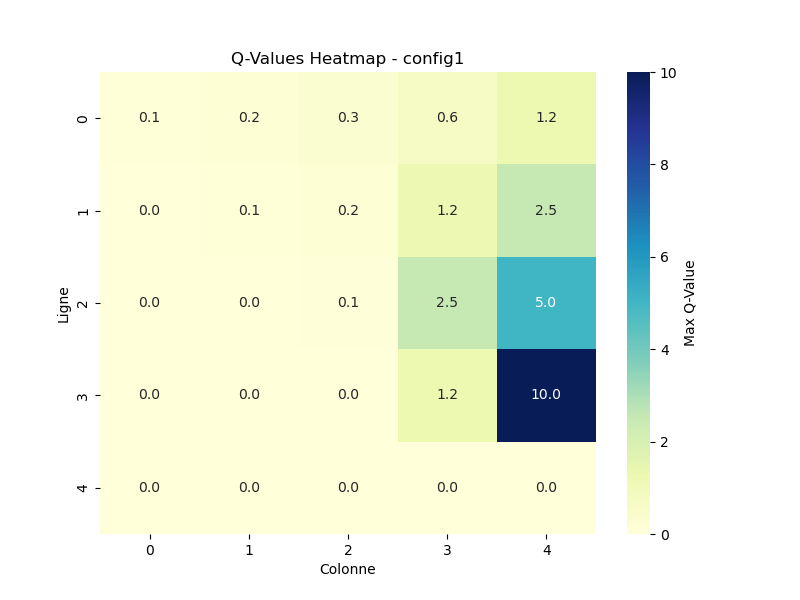
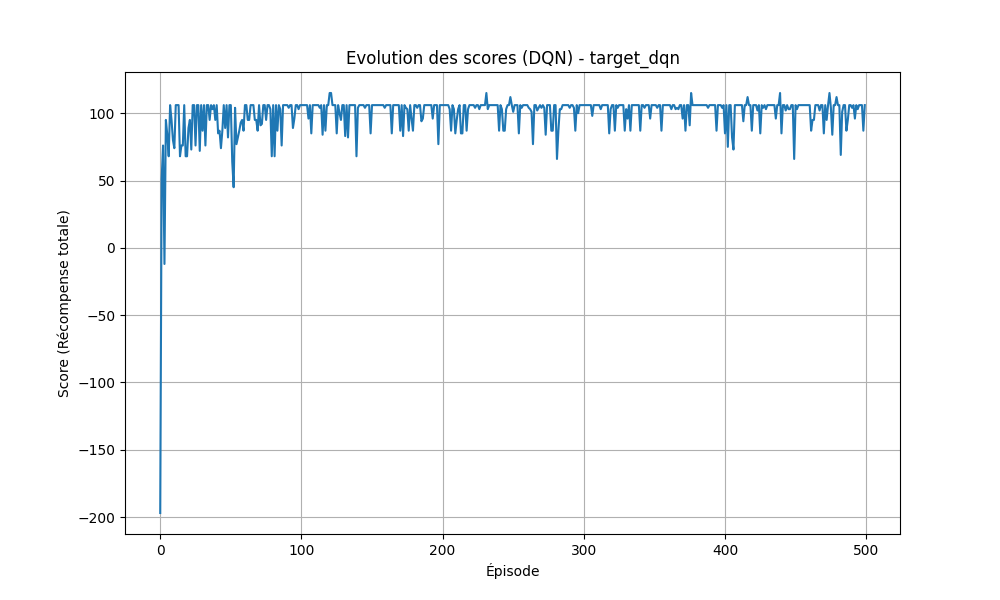
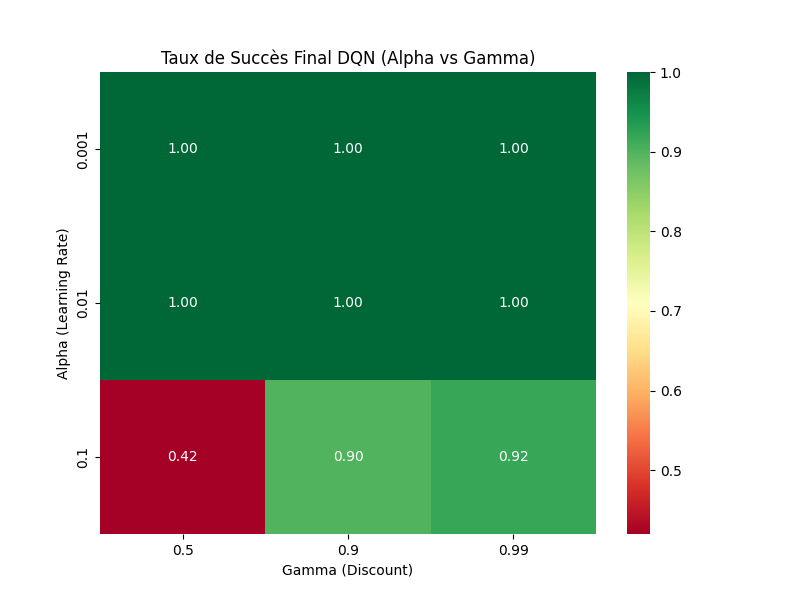
Travaux pratiques du module Machine Learning du Master 2 TDSI (parcours EUR Smart IoT), une série de trois TP : un système expert à chaînage avant pour les Tours de Hanoï, un perceptron puis un perceptron multicouche appliqués à la classification d'images, et enfin ce projet d'apprentissage par renforcement. Le terrain de jeu est un plateau paramétrable (4×4 ou 5×5) : l'agent part d'une case, doit rejoindre le trésor, peut ramasser des diamants, et perd s'il tombe sur un dragon ou sort du plateau. Aucune règle de déplacement ne lui est donnée : il ne connaît que les récompenses reçues, et doit en déduire lui-même une stratégie. Première approche, le Q-Learning tabulaire : une table Q (états × actions) mise à jour à chaque coup, avec une exploration epsilon-greedy. La table apprise se lit directement — carte de politique (la flèche optimale sur chaque case) et heatmap des Q-values, où l'on voit la valeur se propager depuis le trésor vers le point de départ. Avec une première grille de récompenses (trésor 10, dragon −2, diamant 2, sortie −1 ; α = 0,9, γ = 0,5), l'agent résout le plateau en 8 coups. Changer les récompenses change le caractère de l'agent : avec des gains et des pénalités plus contrastés (trésor 30, dragon −10, diamant 10, case vide −1) et un γ plus élevé, il devient gourmand, va chercher un diamant… et échoue. C'est toute la leçon du reward shaping : le comportement obtenu dépend autant de la fonction de récompense que de l'algorithme. Deuxième approche, le Deep Q-Learning : la table est remplacée par un réseau de neurones (entrée one-hot de 16 positions → couche cachée de 16 ReLU → 4 Q-values), entraîné par descente de gradient avec tf.GradientTape. La variante avec réseau cible (Target Network) stabilise l'apprentissage et atteint environ 100 % de réussite, avec une trajectoire optimale en 6 coups. Un balayage des hyperparamètres (α, γ) résumé en heatmap de taux de succès complète l'analyse. Le compte-rendu compare enfin les deux familles de méthodes — empreinte mémoire, interprétabilité, généralisation, passage à l'échelle — et discute de façon critique l'écart de 6 contre 8 coups, qui tient davantage aux conditions d'entraînement qu'à une supériorité intrinsèque du réseau.
Technologies utilisées
- Python
- TensorFlow / Keras
- NumPy
- Q-Learning
- Deep Q-Network
- Target Network
- Matplotlib
- Heatmaps de Q-values
- Cartes de politique
- Courbes de taux de succès
- Balayage d'hyperparamètres
- Epsilon-greedy
- Reward shaping
- Compte-rendu LaTeX
Fonctionnalités
- Environnement de jeu maison : plateau paramétrable, dragons, diamants, trésor
- Q-Learning tabulaire avec exploration epsilon-greedy
- Lecture de la table Q : carte de politique et heatmap des Q-values
- Étude de deux grilles de récompenses et de leur effet sur le comportement
- Deep Q-Learning : réseau 16 → 16 (ReLU) → 4, entraîné avec tf.GradientTape
- Variante Target Network : ~100 % de réussite, trajectoire optimale en 6 coups
- Balayage des hyperparamètres (α, γ) en heatmap de taux de succès
- Analyse critique Q-Learning vs Deep Q-Learning (mémoire, généralisation, scalabilité)
En images